Mellanox Quantum-2 MQM9790 64-port 非阻塞 NDR 400 Gb/s InfiniBand 交换机
面向寻求非阻塞、低延迟网络架构的 AI 训练集群、高性能计算与大型数据中心而量身打造的企业级 400 Gb/s InfiniBand 交换机。
- 提供 25.6 Tbps 交换容量的 64-port 非阻塞架构。
- 32 个 OSFP 笼位,以灵活的 400 Gb/s 扩展支持南北向与东西向流量。
- 精简部署与运维的非管理型即插即用设计。
- 专为高密度机架集成与高效散热而设计的 P2C 气流选项。
- 通过 CB、CE、FCC、VCCI 与 RoHS 标准认证,满足全球部署要求。
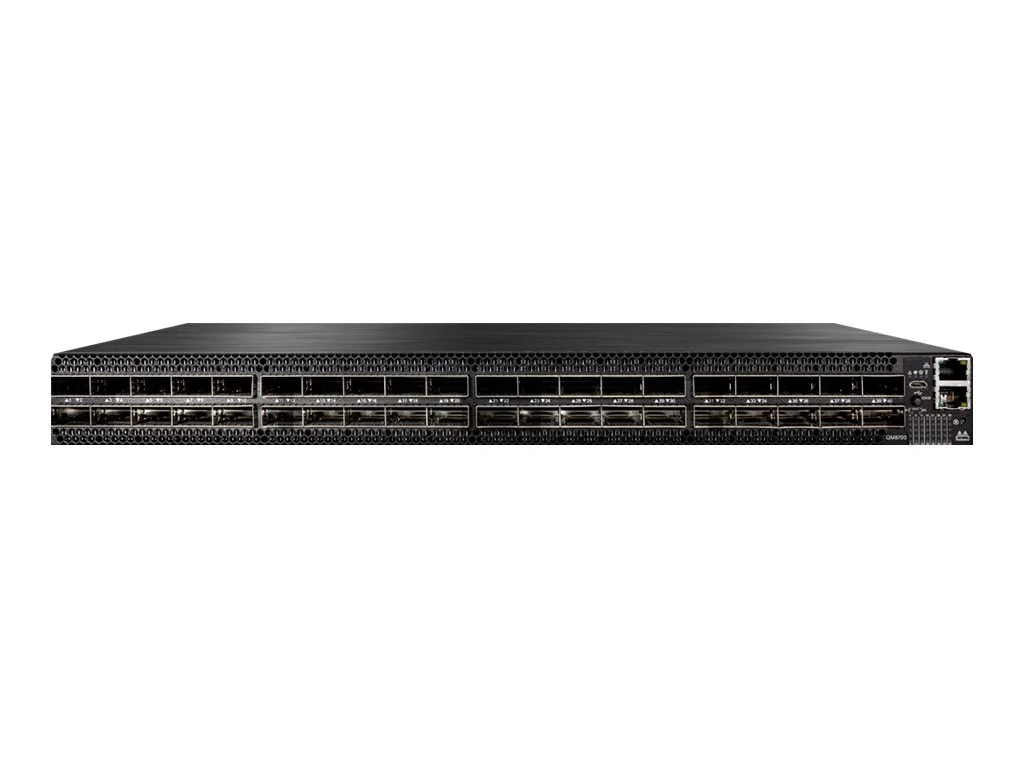
展示 64 个 OSFP 端口与状态指示灯的前视图。
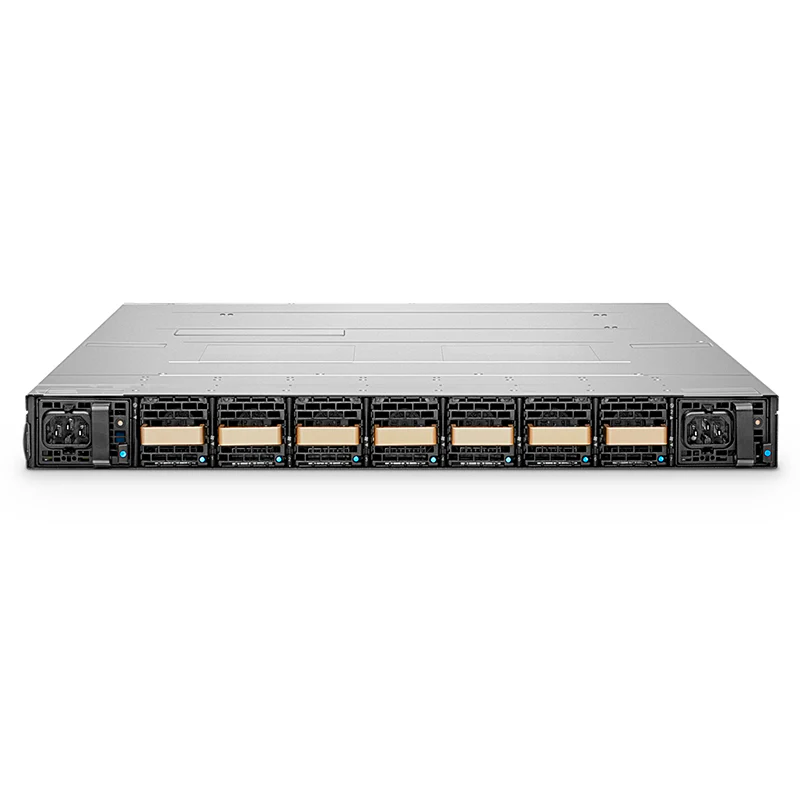
突出冗余电源与散热模块的后视图。
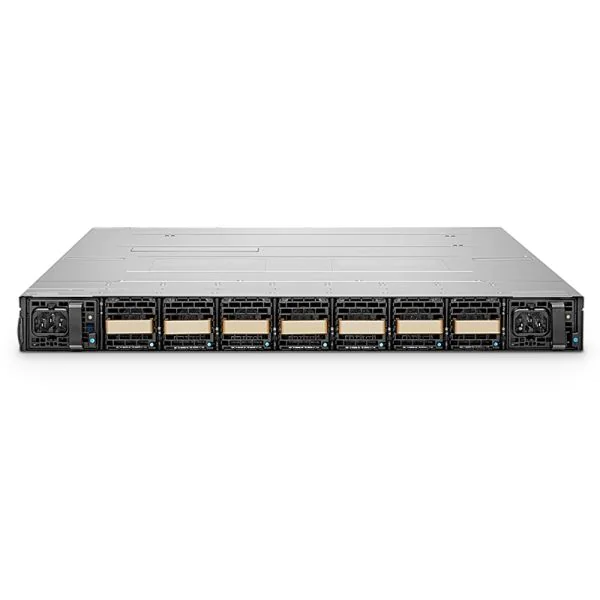
展示紧凑型 1U 机架式设计的侧视图。
需要更多产品照片或配件图?联系我们的销售工程师获取完整媒体资料包。
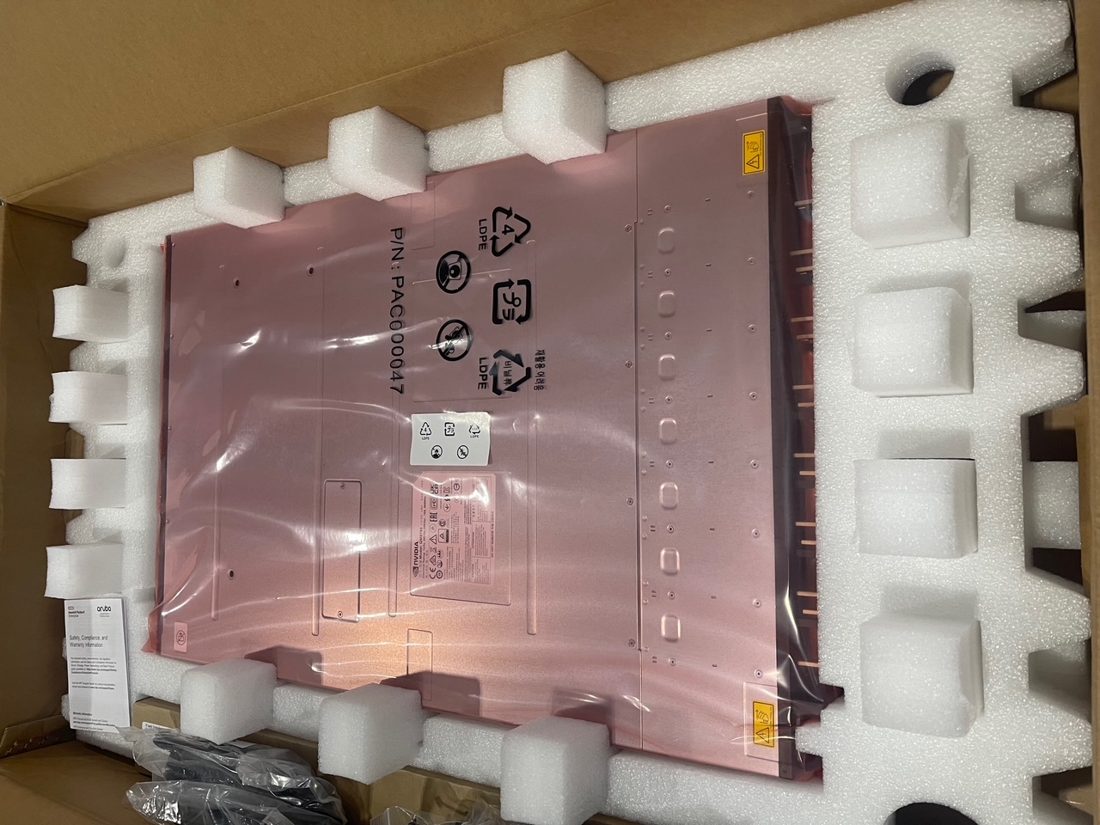
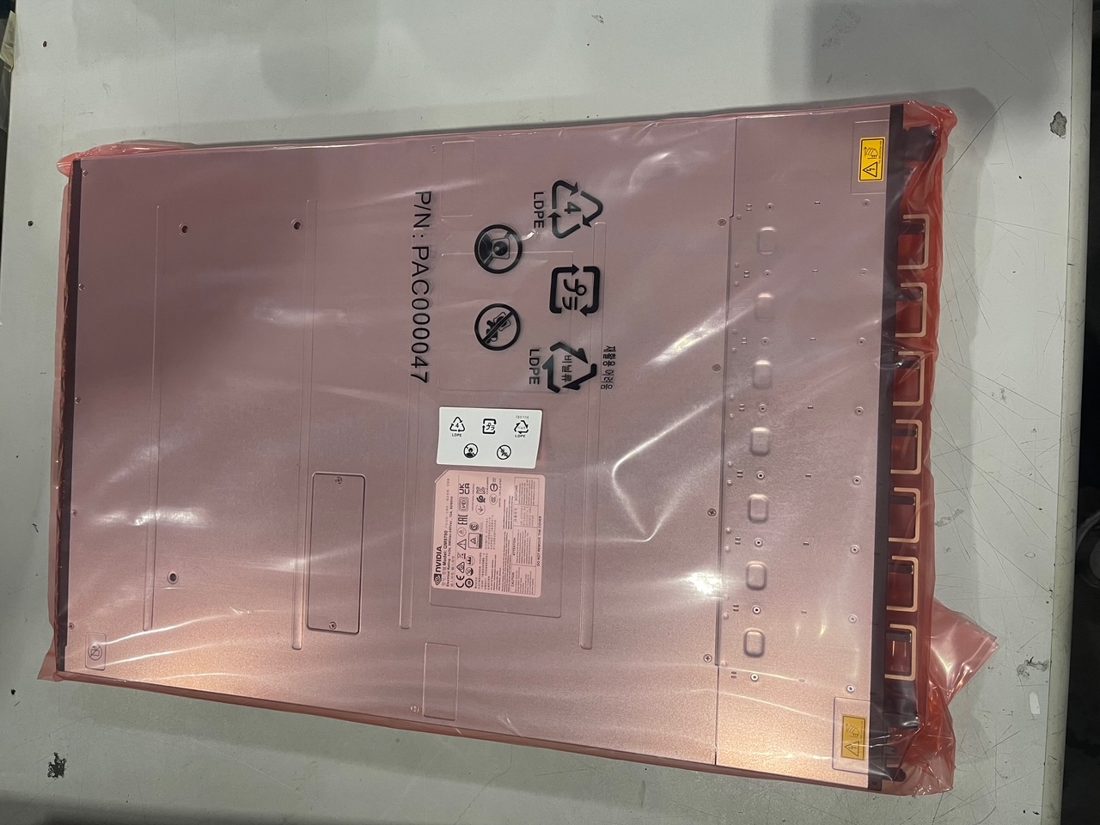
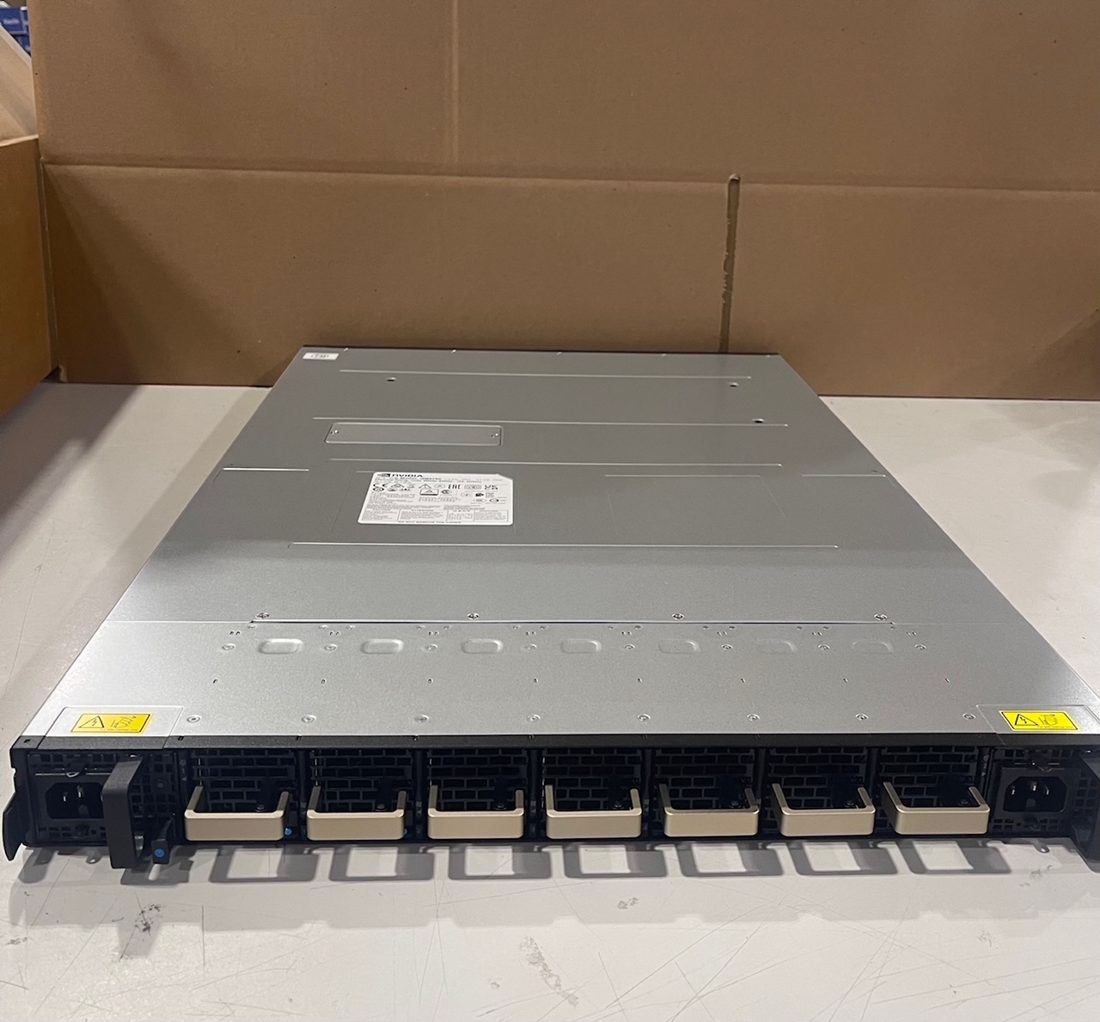
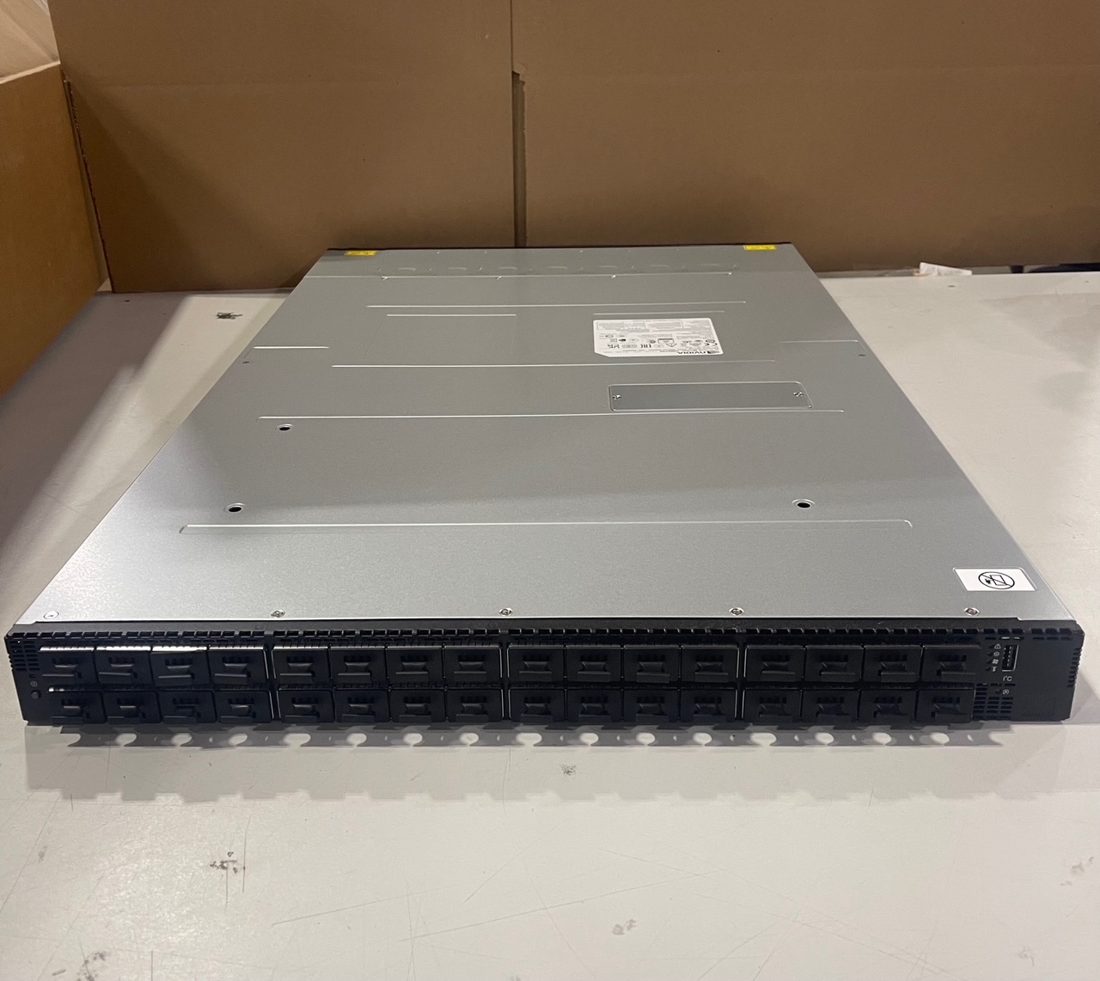
实物照片
当前现货机型的真实照片 —— 全新且原厂密封。
产品概览
Mellanox Quantum-2 MQM9790 64-port 非管理型非阻塞 NDR 400 Gb/s InfiniBand 交换机(部件 ID:MQM9790-NS2F)凭借新一代 NVIDIA Mellanox Quantum™-2 芯片,为现代超大规模数据中心与 AI/HPC 环境提供动力。它在为最严苛工作负载保持非阻塞连接的同时,提供确定性、超低延迟的网络架构性能。
凭借支持灵活分支的 32 个 OSFP 笼位,MQM9790 可适应跨云服务商、超算站点与研究机构的扩展需求。可选的前向或后向气流、热插拔模块与冗余电源,确保在密集机架中实现弹性的 24/7 运行。
涵盖 CB、cTUVus、CE、FCC、VCCI 与 RoHS 的全面全球认证确保跨地区合规,而坚固的环境耐受性支持高海拔部署。其非管理型架构最大限度降低运维复杂性,为大规模网络架构提供可预测的性能。
交换容量
25.6 Tbps
为非水平与垂直扩展而设计的非阻塞交换网络架构。
端口密度
32 OSFP
具备多速率兼容性、面向未来升级的高密度 OSFP 端口。
单端口速率
带宽 400 Gb/s
兼容 40/56/100/200/400 Gb/s 链路,实现灵活集成。
服务
全生命周期
来自 Glocal Storage 的规划、部署、优化与培训服务。
- 企业级可靠性: 配备热插拔模块的冗余电源与风扇保障持续运行。
- AI/HPC 优化: 针对 GPU 间流量调优,具备超低延迟与拥塞控制。
- 全球认证: 符合 CB、CE、FCC 与 RoHS 标准,适用于全球部署。
- 紧凑占地: 紧凑型 1U 机箱在扩展项目中节省机架空间。
- 灵活部署: 为云服务商、超大规模运营商与研究机构而打造。
- 高级管理: 支持 SNMP、CLI、Web UI、NVIDIA UFM 及 RESTful API。
- 高能效: 智能风扇控制与电源管理降低运营成本。
- 多速率支持: 与 HDR/EDR 网络架构的向后兼容性保护您的投资。
技术规格
| 型号 | NVIDIA Mellanox MQM9790-NS2F |
|---|---|
| 品牌 | Mellanox |
| 端口配置 | 64 × 400 Gb/s NDR InfiniBand 端口,32 个 OSFP 笼 |
| 交换容量 | 25.6 Tbps |
| 尺寸 | 17.2" (W) × 1.7" (H) × 26" (D) / 438 mm × 43.6 mm × 660 mm |
| 安装方式 | 标准 19-inch 机架 |
| 工作温度 | P2C 风道:0°C 至 35°C;C2P 风道:0°C 至 40°C |
| 存储温度 | -40°C 至 70°C |
| 工作湿度 | 10%–85% 非冷凝 |
| 存储湿度 | 10%–90% 非冷凝 |
| 海拔 | 工作海拔最高 3,050 米 |
| 风道选项 | P2C(前进后出)/ C2P(后进前出) |
| 输入功率 | 输入:1×/2× 200–240 VAC,10 A,50/60 Hz |
| 最大功率 | 1,610 W(含有源线缆) |
| 典型功率 | 640 W(含无源线缆,ATIS) |
| 安全认证 | 合规认证:CB、cTUVus、CE、CU、S-Mark |
| EMC 认证 | 合规认证:CE、FCC、VCCI、ICES、RCM、CQC、BSMI、KCC、TEC、ANATEL |
| RoHS 合规 | 符合 RoHS |
| 管理功能 | 支持 CLI、SNMP、Web 管理及 NVIDIA Cumulus Linux |
| 嵌入式处理器 | Intel® Core™ i3 Coffee Lake(仅 QM9700 系列) |
应用场景
云数据中心
为多租户与虚拟化平台提供高性能、低延迟连接。
AI/ML 训练集群
针对 GPU 工作负载优化,保持海量带宽与稳定延迟。
高性能计算
以可预测的网络架构性能支撑科学研究、仿真与超级计算项目。
常见问题
需要更多信息?
我们的技术专家随时准备协助您评估配置、部署计划与长期支持选项。
1 Fullerton Road #02-01, One Fullerton, 新加坡